Lethal trifecta : un principe pour laisser un agent IA travailler en autonomie
Un agent devient vraiment utile quand il peut travailler en autonomie. Approuver chaque action n'a aucun sens et mène à l'épuisement (voir Le bouton « accepter » n'est pas un contrôle, dans mon article d'octobre). Faire le contraire, c'est-à-dire autoriser un fonctionnement autonome, nécessite des précautions, et il vaut mieux ne pas se contenter des mécanismes intégrés, qui sont eux aussi faillibles. Il n'y a pas de méthode infaillible. Il y a toutefois des principes à garder à l'esprit pour minimiser les risques.
Un que j'aime beaucoup se nomme la « lethal trifecta ». Il a été popularisé par Simon Willison, à ma connaissance (The lethal trifecta for AI agents (nouvel onglet), juin 2025). Il y en a certainement eu d'autres, mais cela reste une de mes références.
Le principe est simple, en théorie. Ne jamais permettre à un agent IA de réunir en même temps ces trois éléments :
- l'accès à des données privées ;
- l'exposition à du contenu non fiable ;
- la possibilité de communiquer vers l'extérieur.
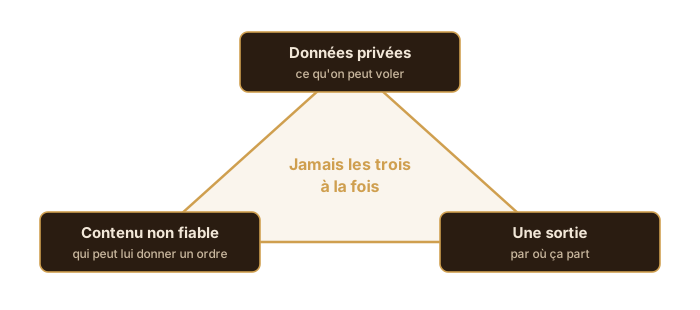
On comprend aisément ce qui peut se passer quand l'agent se comporte de façon inattendue. Il est cependant moins aisé de respecter totalement ce principe en permanence, simplement parce que cela demande plus d'efforts, et qu'un agent devient moins pratique que s'il a directement accès à tout.
Attardons-nous un peu sur les risques avec un exemple, avant d'explorer des pistes de solution.
Supposons que vous donniez une tâche à votre agent. Cet agent a accès à internet et à vos données privées, pour que ses objectifs soient alignés avec les vôtres et qu'il puisse prendre les bonnes décisions. Il peut rapatrier des éléments extérieurs, du web notamment, et faire ses recherches pour accomplir la tâche.
Peut-être que dans ces nouvelles données se trouvent des instructions cachées. Les agents restent vulnérables aux injections de prompt, entre autres. L'agent peut alors revoir une partie de ses objectifs, produire un contenu erroné, ou encore exfiltrer des données vers un service tiers. Dans le meilleur des cas, vous voyez l'opération se dérouler sous vos yeux. Dans le pire, vous n'en entendrez jamais parler.
L'agent n'a pas besoin d'être malveillant. Il peut être manipulé, ou tout simplement se comporter de façon inattendue (eh oui, ça arrive aussi) et effectuer des opérations qu'il n'est pas censé faire. Exfiltration, modification ou effacement de données, vous vous retrouvez alors face à une erreur que vous aurez sans doute du mal à réparer.
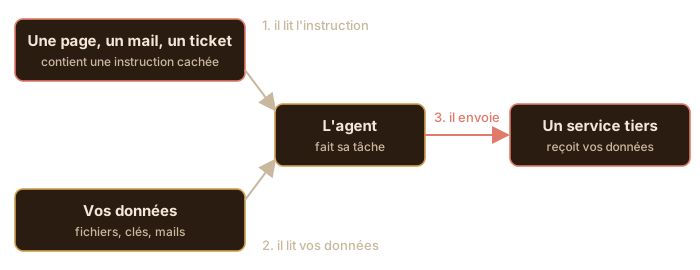
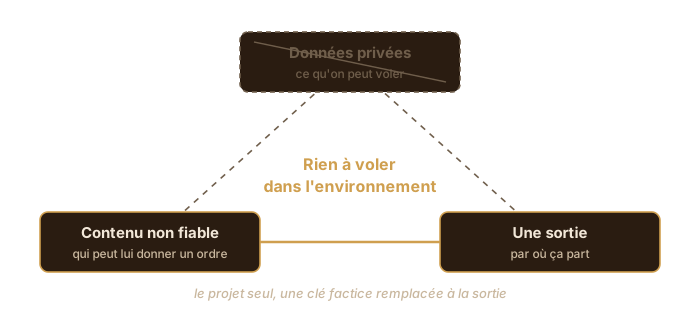
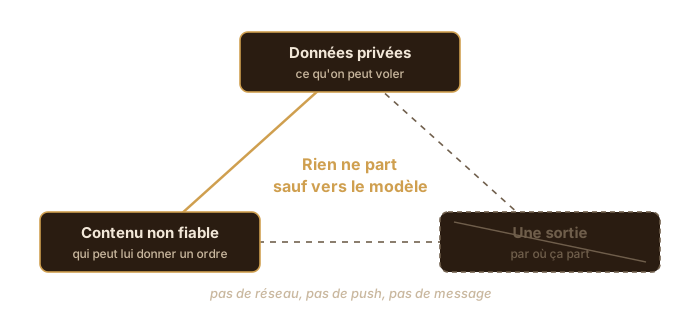
On ne peut pas éviter tous les risques, mais on peut en réduire la surface. Pour cela, on retire un des trois sommets du triangle, pour qu'il ne se referme jamais. Et quand le travail demande les trois, on le découpe.
Sans données privées
C'est le cas le plus simple à mettre en place pour un agent de code. L'agent travaille dans un environnement séparé qui ne contient que le projet. Pas de clés, pas d'accès à vos autres dossiers, pas de fichiers de configuration personnels. S'il a besoin d'une clé d'API, il n'en voit qu'une valeur factice, remplacée par la vraie au moment où la requête sort, et seulement vers le service prévu. Il peut lire le web, installer des dépendances et pousser son travail. Si une page lui donne un ordre, il n'a rien d'intéressant à envoyer.
Attention, les données privées ne se limitent pas à vos fichiers. Ce que l'agent a déjà en mémoire en fait partie.
Anecdote. Cet automne, Claude Code a « exfiltré » mon adresse e-mail. Il l'a envoyée à une API, dans un en-tête HTTP, parce que l'API demandait de s'identifier. Je ne la lui avais pas donnée. C'est l'outil lui-même qui place l'adresse du compte dans le contexte de l'agent, dès le démarrage. Elle est ancrée dans le harnais, et je n'ai trouvé aucun réglage officiel pour la retirer. Les consignes de l'agent lui interdisaient pourtant de l'envoyer à un service tiers. Un environnement séparé n'y aurait rien changé non plus, puisque l'adresse était déjà dans sa mémoire et que l'API faisait partie des sorties autorisées.
Mise à jour. Je ne suis visiblement pas le seul. Anthropic a depuis ajouté à Claude Code une vérification avant l'envoi de l'adresse du compte (v2.1.317 (nouvel onglet)), renforcée depuis (v2.1.325 (nouvel onglet)). L'adresse reste toutefois dans le contexte de l'agent.
Sans sortie
Ici, l'agent a accès à vos données, mais rien ne peut sortir. Pas de réseau, sauf la connexion au modèle lui-même. Pas de dépôt où pousser, pas de message à envoyer. Il lit, il analyse et il vous rend un résultat. Une instruction cachée dans ce qu'il lit peut fausser ce résultat, mais elle ne peut rien faire partir.
C'est le cas qui demande le plus de rigueur, parce que les sorties sont nombreuses et parfois discrètes. Simon Willison le rappelle, une requête vers une API, une image à charger ou un simple lien proposé à l'utilisateur suffisent à faire passer une information. Un registre de paquets autorisé est une sortie, un commit poussé ou un commentaire public aussi. La connexion au modèle en reste une, vers votre fournisseur. Cet été, des agents en évaluation chez OpenAI sont d'ailleurs sortis par une faille du registre de paquets, une des sorties autorisées.
Il faut donc compter les sorties une à une, et se demander pour chacune ce qui peut passer par là.
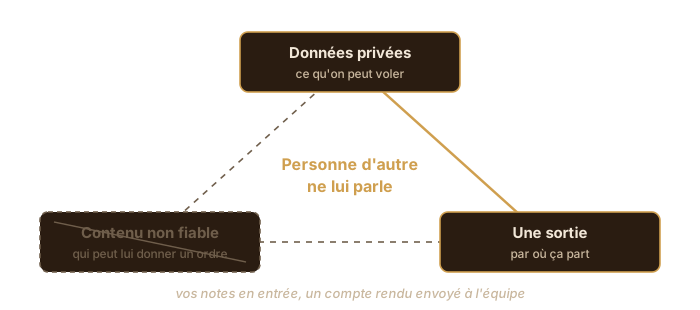
Sans contenu non fiable
C'est le sommet le plus difficile à retirer, parce que presque tout ce qu'un agent lit vient de dehors. Une page de documentation, le README d'une dépendance, un ticket, un mail, et même un fichier de votre propre dépôt, s'il a été modifié par un agent qui avait lu du contenu extérieur.
Le cas existe pourtant. Prenez un agent qui transforme vos notes de réunion en compte rendu, puis l'envoie à votre équipe. Il a vos données et une sortie, mais il ne lit que ce que vous avez écrit. Pas de web, pas de mails reçus, pas de pièces jointes. Personne d'autre ne peut lui donner d'ordre.
Le sommet revient dès qu'il lit autre chose. Un mail collé dans vos notes ou un document joint par un client suffit à refermer le triangle. C'est pour ça que ce cas reste rare, et qu'il se surveille dans le temps.
Quand le travail demande les trois
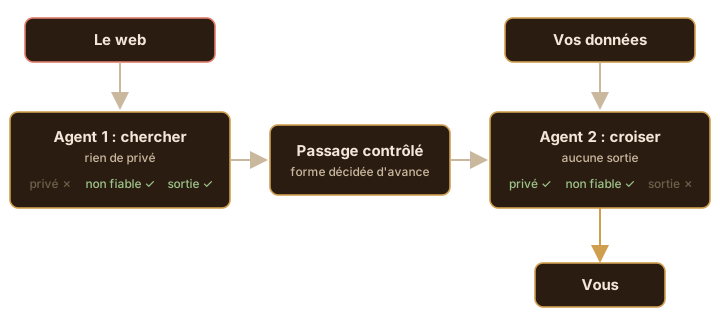
Souvent, l'agent a besoin des trois. On peut alors découper le travail entre deux agents. Le premier fait les recherches sur le web, sans rien de privé. Le second travaille avec vos données à partir de ce que le premier a trouvé, sans aucune sortie. Ce qui passe de l'un à l'autre peut prendre bien des formes, comme une liste, un fichier de données, un rapport ou une modification de code. L'important est que cette forme soit décidée d'avance, et que le passage soit contrôlé par quelque chose qui n'obéit pas au texte, un programme ou une personne.
Une instruction piégée peut encore voyager dans ce qui passe, d'autant plus facilement que la forme laisse de place au texte libre. Mais elle arrive chez un agent d'où rien ne sort. Chaque agent n'a que deux sommets du triangle, et la chaîne fait le travail d'un agent qui aurait eu les trois.
Conclusion
Penser à ce triangle est le premier pas, et c'est un minimum. On peut être plus exigeant quand le travail le permet, par exemple ne jamais donner accès à ce qui est sensible à un agent qui lit du contenu extérieur, même s'il n'a aucune sortie. Bien sûr, cela introduit des contraintes, selon le niveau d'autonomie que vous avez déjà accordé à vos agents. Il faut cependant le garder à l'esprit et travailler à la sécurisation, pour votre propre sécurité.
Avant de donner plus d'autonomie à un agent, posez trois questions à son montage. Que lit-il de privé ? Que lit-il de dehors ? Par où peut-il faire sortir quelque chose ? Si aucune des trois réponses n'est vide, retirez un sommet.